

Databricks Lakeflow ist die einheitliche Data-Engineering-Lösung von Databricks für Datenaufnahme, Transformation und Orchestrierung, seit Juni 2025 allgemein verfügbar. Sie fasst die frühere Delta Live Tables (heute Lakeflow Declarative Pipelines), Databricks Workflows (heute Lakeflow Jobs) und neue Ingestion-Konnektoren (Lakeflow Connect) unter einem gemeinsamen Dach zusammen. Bestehender Code läuft dabei ohne Zwang zur Migration weiter, Governance läuft durchgängig über Unity Catalog.
Die Terminologie rund um Databricks hat sich in den letzten zwei Jahren spürbar verschoben, und wer zuletzt vor 2025 mit Delta Live Tables gearbeitet hat, stolpert inzwischen über Begriffe wie Lakeflow Connect, Lakeflow Jobs oder Spark Declarative Pipelines. Für IT-Verantwortliche im Mittelstand stellt sich dabei eine ganz praktische Frage: Ist das ein neues Produkt, das man evaluieren muss, oder einfach ein neuer Name für etwas, das man schon kennt?
Nach diesem Artikel wissen Sie, aus welchen Komponenten Lakeflow besteht, was sich gegenüber DLT und Databricks Workflows konkret geändert hat, und ob sich eine Beschäftigung mit dem Thema für Ihr Unternehmen jetzt lohnt.
Fangen wir mit dem Kern an.
Was ist Databricks Lakeflow?
Lakeflow ist Databricks einheitliche Lösung für Data Engineering, die Datenaufnahme (Ingestion), Transformation und Orchestrierung von Datenpipelines in einem gemeinsamen Produkt zusammenführt, statt sie über separate Tools zu verteilen. Seit Juni 2025 ist Lakeflow allgemein verfügbar (General Availability) und läuft nativ auf AWS, Azure und Google Cloud.
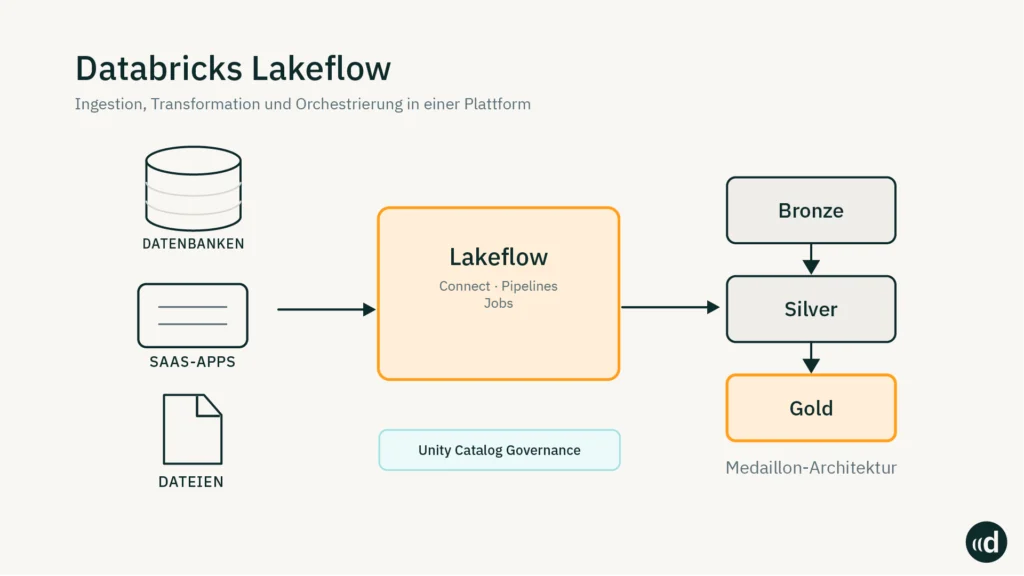
Lakeflow ist also keine komplett neue Erfindung, sondern eine Art Zusammenfassung von bestehenden Databricks-Bausteinen unter einem gemeinsamen Namen. Für die deklarative Transformation haben wir Delta Live Tables (DLT), für die Orchestrierung Databricks Workflows und für die Datenbanken und Unternehmensanwendungen neue, verwaltete Ingestion-Konnektoren.
Der Grund dafür ist ein Problem, das wir in fast jedem Projekt sehen: Data-Engineering-Teams verknüpfen im Alltag mehrere unabhängige Tools für die Datenaufnahme, das Datenmapping und die Planung. Diese haben jeweils eigene Schwachstellen und verursachen eigenen Aufwand. Lakeflow legt diese drei Aufgaben auf eine Plattform, die Unity Catalog verwaltet.
Lakeflow vs. Delta Live Tables:
- Delta Live Tables war das deklarative Framework für Transformationspipelines, mit
import dltals Python-Schnittstelle - Lakeflow Declarative Pipelines ist die direkte Weiterentwicklung von DLT, technisch kompatibel, mit neuer API (
from pyspark import pipelines as dp) und offenem Fundament in Apache Spark - Der Unterschied: Bestehender DLT-Code läuft unverändert weiter, für Neuentwicklungen empfiehlt Databricks aber den Wechsel auf die neue Schreibweise
Machen Sie Databricks zu Ihrem Wettbewerbsvorteil
Mit unserer Databricks-Beratung entwickeln Sie eine skalierbare Architektur, realisieren produktive Use Cases und befähigen Ihr Team nachhaltig.
Wie funktioniert Lakeflow? Die drei Komponenten im Zusammenspiel
Für IT-Verantwortliche ist weniger die einzelne Funktion interessant als die Frage, wie die drei Bausteine zusammenspielen und wo im bestehenden Data-Stack sie ansetzen.
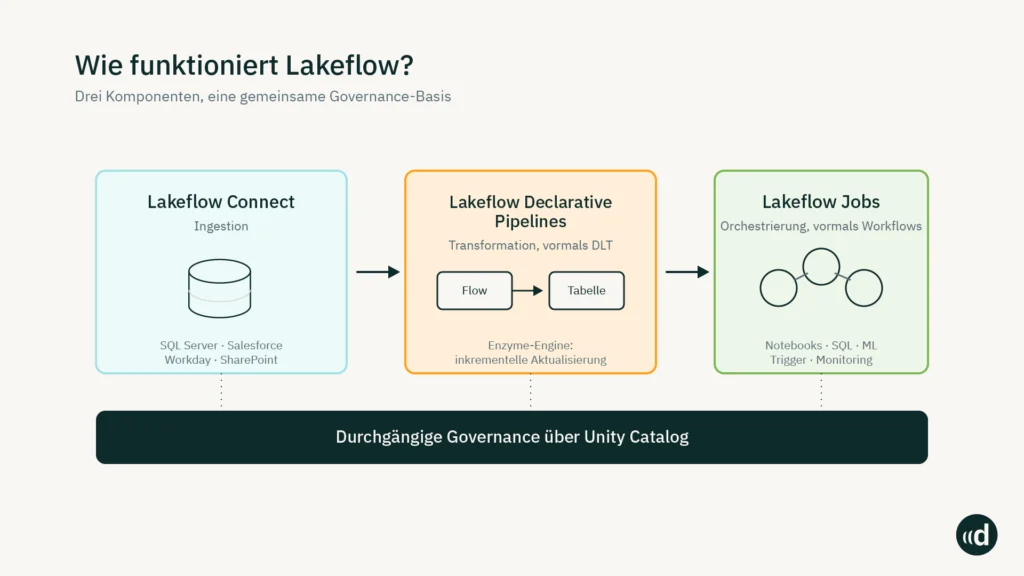
| Komponente | Funktion | Relevanz für Unternehmen |
|---|---|---|
| Lakeflow Connect | Verwaltete Konnektoren für Datenbanken (SQL Server, Postgres, Oracle) und Unternehmensanwendungen (Salesforce, Workday, SharePoint) | Eigene Connector-Infrastruktur entfällt, Ingestion neuer Quellen dauert Tage statt Wochen |
| Lakeflow Declarative Pipelines | Deklaratives Transformationsframework, vormals Delta Live Tables, für Streaming- und Batch-ETL | Data Engineers definieren den Zielzustand einer Tabelle, die Ausführungsplanung übernimmt die Runtime automatisch |
| Lakeflow Jobs | Orchestrierung, vormals Databricks Workflows, koordiniert Notebooks, Pipelines, SQL-Queries und ML-Training in einem gemeinsamen Ablaufplan | Ein einziger Orchestrator statt separater Scheduling-Tools, mit Kontrollflusslogik und Monitoring |
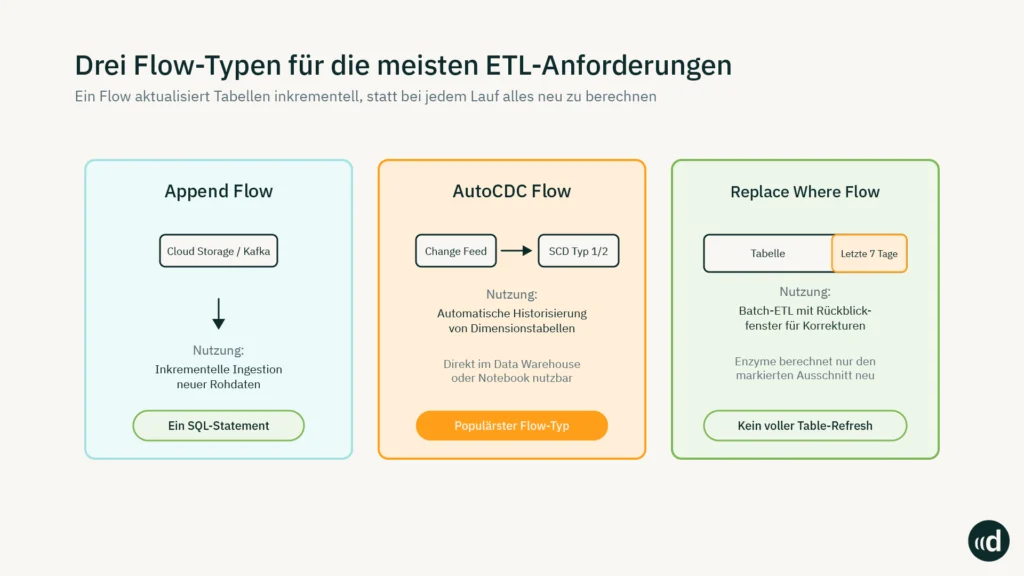
Kern der Transformationsschicht ist das Konzept des Flows: ein zustandsbehafteter Datenprozess, der Tabellen inkrementell aktualisiert, statt bei jedem Lauf alles neu zu berechnen.
Drei Flow-Typen decken dabei den Großteil gängiger ETL-Anforderungen ab:
- Der Append Flow übernimmt inkrementelle Ingestion aus Cloud Storage oder Kafka-Streams.
- Der AutoCDC Flow baut aus Change-Feeds automatisch historisierte Tabellen nach SCD Type 1 oder Type 2 auf, ein Muster, das in klassischen ETL-Tools oft mehrere hundert Zeilen Code braucht und sich mit AutoCDC auf wenige Zeilen SQL oder Python reduziert.
- Der Replace-Where-Flow eignet sich für Batch-Verarbeitung mit einem Rückblickfenster, etwa wenn täglich nur die letzten sieben Tage neu berechnet werden müssen, weil verspätet eintreffende Daten oder Korrekturen einfließen.
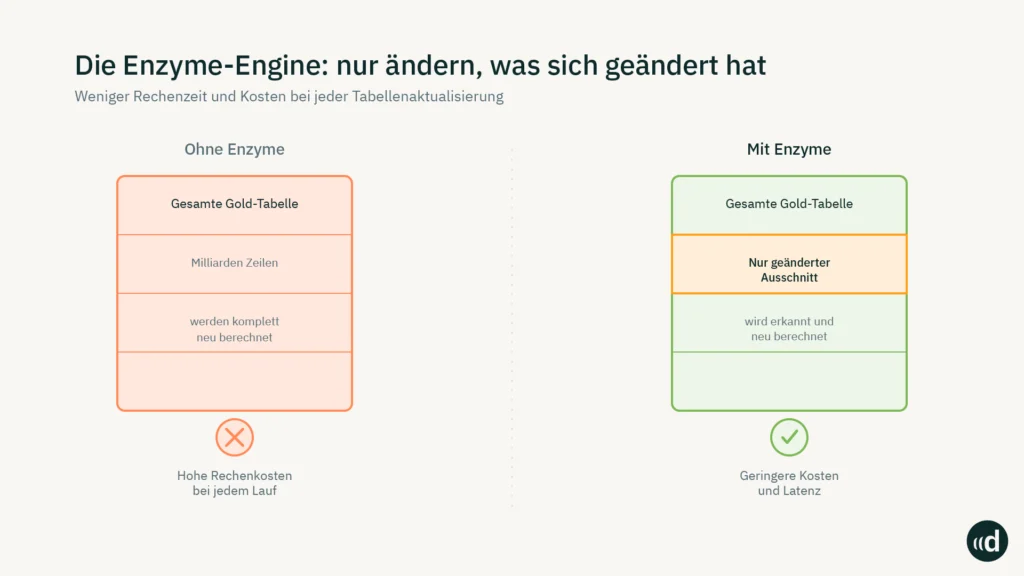
Hinter dieser Inkrementalisierung steht die sogenannte Enzyme-Engine. Sie erkennt automatisch, welcher Teil einer Tabelle sich geändert hat. Und sie rechnet nur diesen Teil neu. Für Unternehmen bedeutet das: Lakeflow aktualisiert nur die betroffenen Ausschnitte. Dadurch werden Rechenkosten und Latenz gesenkt.
Welche 5 Vorteile bringt Lakeflow Unternehmen konkret?
1. Weniger Tool-Wildwuchs, ein gemeinsamer Data-Engineering-Stack
Statt Ingestion-Tool, ETL-Framework und Orchestrator einzeln zu lizenzieren, zu betreiben und abzusichern, laufen alle drei Aufgaben über eine gemeinsame Plattform, die von Unity Catalog verwaltet wird. Das spart Lizenzen und den Aufwand für die Wartung mehrerer Systeme.
2. Durchgängige Governance ohne Systembrüche
Weil Lakeflow Connect, Declarative Pipelines und Jobs alle über Unity Catalog laufen, gilt die Zugriffskontrolle, das Lineage-Tracking und die Datenqualitätsüberwachung durchgängig über den gesamten Pipeline-Lebenszyklus hinweg. Für bestimmte Branchen wie Automotive, Pharma oder Finanzdienstleister im Mittelstand entfällt damit die sonst übliche Lücke zwischen den Tools für die Datenverwaltung und -umwandlung.
3. Geringerer Migrationsaufwand als der Namenswechsel vermuten lässt
Wer heute bereits mit Delta Live Tables arbeitet, muss nicht bei null anfangen. Die Migration läuft überwiegend auf API-Ebene: Import-Anweisungen und Decorator-Namen werden angepasst, die zugrunde liegende Pipeline-Logik bleibt meist unverändert. In unseren Projekten sehen wir, dass sich dieser Aufwand für eine mittelgroße Pipeline-Landschaft in wenigen Personentagen erledigen lässt, nicht in Wochen.
4. Weniger Code für gängige, aber aufwendige ETL-Muster
Historisierte Dimensionstabellen nach SCD Type 1 oder Type 2 gehören zu den Mustern, die in klassischen ETL-Pipelines besonders fehleranfällig und wartungsintensiv sind. Der AutoCDC Flow bildet dieses Muster mit wenigen Zeilen SQL ab, inklusive automatischer Historisierung.
5. Eingebaute Datenqualitätsprüfung statt nachgelagerter Kontrolle
Über sogenannte Expectations lassen sich Datenqualitätsregeln direkt in der Pipeline-Definition festlegen, etwa dass eine Spalte nicht leer sein darf oder ein Wertebereich eingehalten werden muss. Verstöße werden sofort im Dataflow Graph sichtbar, statt erst in einem nachgelagerten BI-Bericht aufzufallen.

Expertentipp von Laurenz, CTO bei Datasolut:
Der Vorteil, den Kunden nach der Einführung am häufigsten überraschend positiv zurückmelden, ist nicht die reine Rechenzeitersparnis durch Enzyme, sondern wie viel schneller neue Datenquellen angebunden sind, wenn Ingestion, Transformation und Orchestrierung nicht mehr über drei verschiedene Tools laufen. Ein Anschluss, der vorher eine Woche Abstimmung zwischen Teams gekostet hat, ist mit Lakeflow Connect oft an einem Nachmittag erledigt.
Für wen lohnt sich Lakeflow? Lakeflow vs. DLT vs. Microsoft Fabric
Databricks Lakeflow lohnt sich besonders, wenn:
- Ihr Unternehmen bereits auf Databricks arbeitet und heute mehrere separate Tools für Ingestion, ETL und Scheduling betreibt
- Ihr Data-Engineering-Team durch manuelle Anbindung neuer Datenquellen zum Flaschenhals wird
- Sie historisierte Dimensionstabellen (SCD Type 1/2) pflegen und dafür bislang viel Eigenentwicklung nötig war
- Governance und Lineage über mehrere Tools hinweg heute fragmentiert sind
Lakeflow ist (noch) nicht der richtige Fokus, wenn:
- Sie noch keine Databricks-Plattform betreiben und die Grundsatzentscheidung Databricks vs. Microsoft Fabric noch aussteht, denn dann kommt Lakeflow erst nach der Plattformwahl ins Spiel
- Ihre bestehenden DLT-Pipelines stabil laufen und aktuell keine neue Ingestion-Anforderung ansteht, dann ist Zuwarten legitim, da Rückwärtskompatibilität gewährleistet ist
Zur Einordnung gegenüber Delta Live Tables halten wir fest, was sich wirklich geändert hat: Lakeflow ist kein Ersatz für DLT, sondern dessen Weiterführung unter neuem Namen und mit erweiterten Fähigkeiten, ergänzt um Connect und Jobs als gleichwertige Bausteine. Wer heute auf DLT setzt, verliert nichts, wenn er nicht migriert, gewinnt aber neue Ingestion-Konnektoren und die feinere Flow-Struktur, wenn er es tut.
Bei der Frage Databricks Lakeflow versus Microsoft Fabric geben wir bewusst kein pauschales Urteil ab, sondern eine klare Entscheidungsregel: Wer bereits vollständig im Microsoft-Ökosystem verankert ist und primär BI-nahe Anwendungsfälle abdecken will, sollte Fabric ernsthaft prüfen.
Wer anspruchsvolle ML- oder KI-Workloads plant, mehrere Cloud-Anbieter parallel nutzt oder eine offene, Spark-basierte Architektur ohne Vendor-Lock-in bevorzugt, kommt an Databricks und damit an Lakeflow kaum vorbei. Das ist unsere Einschätzung aus über 30 abgeschlossenen Databricks-Projekten, nicht eine allgemeine Empfehlung ohne Kontext.
Databricks-Migration planen? Wir helfen.
Ob DLT-Migration, Lakeflow-Neueinführung oder die Grundsatzfrage Databricks vs. Fabric: Wir bringen die Projekterfahrung aus über 30 abgeschlossenen Databricks-Projekten mit, damit Sie nicht für Lernkurven zahlen, die wir bereits durchlaufen haben.
Lakeflow mit uns umsetzen, so gehen Sie vor
Klarheit über Ihren aktuellen Data-Stack und Migrationsbedarf
Bevor eine Lakeflow-Einführung sinnvoll geplant werden kann, braucht es eine ehrliche Bestandsaufnahme: Welche Ingestion-Tools, ETL-Pipelines und Orchestratoren sind heute im Einsatz, wie viele davon liegen bereits als DLT-Code vor, und wo entstehen die größten Governance-Lücken?
Wir nehmen diese Bestandsaufnahme im Rahmen unseres DSX Lakehouse Frameworks strukturiert vor, damit die Migrationsentscheidung auf einer belastbaren Grundlage steht, statt auf Bauchgefühl.
Zielarchitektur mit Unity Catalog als Governance-Fundament
Im zweiten Schritt legen wir fest, welche Datenquellen über Lakeflow Connect angebunden werden, welche bestehenden DLT-Pipelines migriert und welche Orchestrierungsaufgaben in Lakeflow Jobs überführt werden. Unity Catalog bildet dabei durchgängig das Governance-Fundament, damit Zugriffsrechte und Lineage von Anfang an konsistent mitgedacht sind, statt nachträglich aufgesetzt zu werden.
Rollout und Team-Enablement für den produktiven Betrieb
Der letzte Schritt ist die eigentliche Umsetzung samt Wissenstransfer an Ihr Team. Weil sich Migrationen bei stabilem Kompatibilitätsversprechen von Databricks in aller Regel schrittweise durchführen lassen, können wir einzelne Pipelines pilotieren, bevor die gesamte Landschaft umgestellt wird, und so das Risiko produktiver Ausfälle gering halten.
Fazit: Lakeflow ist eine Konsolidierung, kein Grund zur Eile
Die wichtigste Erkenntnis aus diesem Artikel: Sie müssen Lakeflow nicht unter Zeitdruck testen. Es verbindet Werkzeuge, die Sie im Databricks-Umfeld vermutlich schon einsetzen. Sie sollten sich damit beschäftigen, wenn eine neue Datenquelle angebunden werden soll, eine bestehende DLT-Pipeline ohnehin überarbeitet wird oder Ihr Data-Engineering-Team mit mehreren Einzeltools überfordert ist.
Wer diese Trigger bei sich erkennt, sollte die Migration aktiv angehen, statt sie auf unbestimmte Zeit zu verschieben, denn der Aufwand ist überschaubarer, als der Namenswechsel vermuten lässt. Wenn Sie unsicher sind, wo Ihr Unternehmen bei dieser Einschätzung steht, klären wir das im nächsten Schritt gemeinsam.
Ihr nächster Schritt mit uns!
Databricks ist eine der leistungsfähigsten Plattformen für Daten und KI – aber ihr volles Potenzial entfaltet sich erst, wenn Ihr Team sie wirklich beherrscht. Lassen Sie uns gemeinsam schauen, welche Schulungspakete zu Ihrer Ausgangssituation passen.
Im kostenlosen Erstgespräch klären wir:
- Welche Rollen und Teams von welchem Paket am meisten profitieren
- Ob und wie wir Inhalte auf Ihre Datenarchitektur und Use Cases anpassen
- Wie ein realistischer Zeitplan und die nächsten Schritte aussehen
Häufig gestellte Fragen zu Databricks Lakeflow
Delta Live Tables (DLT) ist in Lakeflow Declarative Pipelines aufgegangen und damit Teil des breiteren Lakeflow-Produkts. Bestehender DLT-Code läuft ohne Zwangsmigration weiter. Neu hinzugekommen sind Lakeflow Connect für verwaltete Ingestion und Lakeflow Jobs als Weiterentwicklung von Databricks Workflows, beide unter derselben Unity-Catalog-Governance.
Nein. Databricks garantiert Rückwärtskompatibilität für bestehenden DLT-Code, eine Migration ist optional und zeitlich nicht erzwungen. Für Neuentwicklungen empfiehlt sich die neue Lakeflow-API dennoch, da künftige Funktionen darauf aufbauen.
Ja, Lakeflow ist Cloud-unabhängig auf allen drei großen Hyperscalern verfügbar, da Databricks als plattformunabhängige Lakehouse-Lösung konzipiert ist. Das unterscheidet Lakeflow von Microsoft Fabric, das ausschließlich im Azure-Ökosystem läuft.
Lakeflow eignet sich sowohl für Konzerne als auch für Mittelstandsunternehmen mit 1.000 bis 10.000 Mitarbeitenden, insbesondere wenn ein kleines Data-Engineering-Team mehrere Ingestion-Anfragen parallel bedienen muss. Das nutzungsbasierte Preismodell und No-Code-Optionen senken die Einstiegshürde zusätzlich.
Der Aufwand ist überwiegend ein API-Refactoring: Import-Anweisungen und Decorator-Namen werden angepasst, die zugrunde liegende Pipeline-Logik bleibt meist unverändert. Für eine mittelgroße Pipeline-Landschaft lässt sich das erfahrungsgemäß in wenigen Personentagen umsetzen, nicht in Wochen.
Lakeflow Jobs kann bestehende Databricks Workflows direkt ersetzen, da es deren Weiterentwicklung ist. Externe Orchestratoren außerhalb von Databricks lassen sich meist schrittweise ablösen, ein abrupter Parallelbetrieb ist während der Übergangsphase aber technisch problemlos möglich.